常用算法
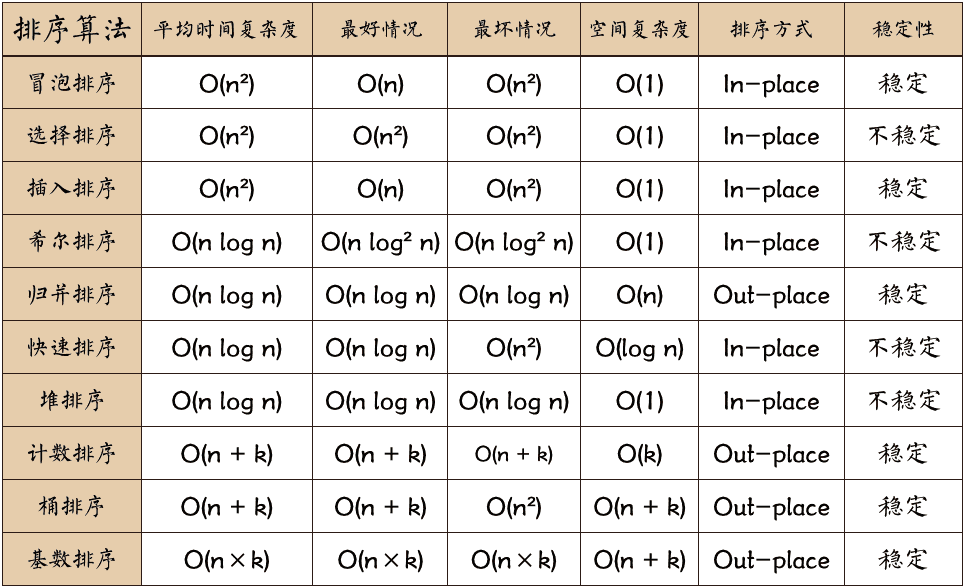
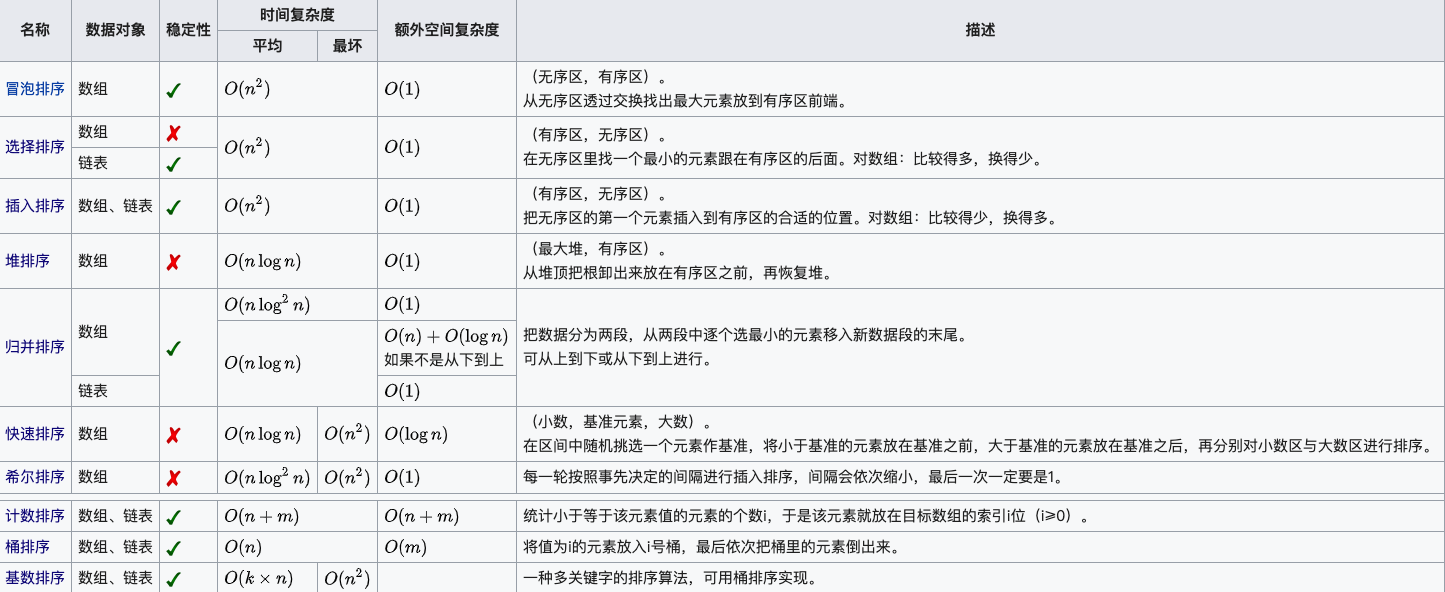
| 排序算法 | 描述 | 是否是稳定排序 | 时间复杂度 | 空间复杂度 |
| 冒泡排序 | 1. 比较相邻的元素。如果第一个比第二个大,就交换它们两个; 2. 对每一对相邻元素作同样的工作,从开始第一对到结尾的最后一对,这样在最后的元素应该会是最大的数; 3. 针对所有的元素重复以上的步骤,除了最后一个; 4. 重复步骤1~3,直到排序完成。 | 稳定排序 | ||
| 选择排序 | 1. 在未排序序列中找到最小(大)元素,存放到排序序列的起始位置 2. 从剩余未排序元素中继续寻找最小(大)元素,然后放到已排序序列的末尾。 3. 重复第二步,直到所有元素均排序完毕。 | 用数组实现不稳定 用链表实现则稳定 | O(n^2) | |
| 插入排序 | 1. 把待排序的数组分成已排序和未排序两部分,初始的时候把第一个元素认为是已排好序的。 2. 从第二个元素开始,在已排好序的子数组中寻找到该元素合适的位置并插入该位置。 3. 重复上述过程直到最后一个元素被插入有序子数组中。 | 稳定排序 | ||
| 归并排序 | - 递归法(Top-down) - 申请空间,使其大小为两个已经排序序列之和,该空间用来存放合并后的序列 - 设定两个指针,最初位置分别为两个已经排序序列的起始位置 - 比较两个指针所指向的元素,选择相对小的元素放入到合并空间,并移动指针到下一位置 - 重复步骤3直到某一指针到达序列尾 - 将另一序列剩下的所有元素直接复制到合并序列尾 - 迭代法(Bottom-up) 原理如下(假设序列共有n个元素): - 将序列每相邻两个数字进行归并操作,形成ceil(n/2)个序列,排序后每个序列包含两/一个元素 - 若此时序列数不是1个则将上述序列再次归并,形成ceil(n/4)个序列,每个序列包含四/三个元素 - 重复步骤2,直到所有元素排序完毕,即序列数为1 | |||
| 快速排序 | ||||
 | ||||
 |
C++STL容器
顺序容器:
1**、**vector
连续存储结构,每个元素在内存上是连续的;支持 高效的随机访问和在尾端插入/删除操作,但其他位置的插入/删除操作效率低下; 相当于一个数组,但是与数组的区别为:内存空间的扩展。vector支持不指定vector大小的存储,但是数组的扩展需要程序员自己写。
vector的内存分配实现原理:
STL内部实现时,首先分配一个非常大的内存空间预备进行存储,即capacity()函数返回的大小,当超过此分配的空间时再整体重新放分配一块内存存储( VS6.0是两倍,VS2005是1.5倍),所以 这给人以vector可以不指定vector即一个连续内存的大小的感觉。通常此默认的内存分配能完成大部分情况下的存储。
扩充空间(不论多大)都应该这样做:
(1)配置一块新空间
(2)将旧元素一一搬往新址
(3)把原来的空间释放还给系统
注:vector 的数据安排以及操作方式,与array 非常相似。两者的唯一差别在于空间的利用的灵活性。Array 的扩充空间要程序员自己来写。
vector类定义了好几种构造函数,用来定义和初始化vector对象:
vector<T> v1; vector保存类型为T的对象。默认构造函数v1为空。
vector<T> v2(v1); v2是v1的一个副本。
vector<T> v3(n, i); v3包含n个值为i的元素。
vector<T> v4(n); v4含有值初始化的元素的n个副本。
2**、**deque
连续存储结构,即其每个元素在内存上也是连续的,类似于vector,不同之处在于, deque提供了两级数组结构, 第一级完全类似于vector,代表实际容器;另一级维护容器的首位地址。这样,deque除了具有vector的所有功能外, 还支持高效的首/尾端插入/删除操作。
deque 双端队列 double-end queue
deque是在功能上合并了vector和list。
优点:(1) 随机访问方便,即支持[ ]操作符和vector.at()
(2) 在内部方便的进行插入和删除操作
(3) 可在两端进行push、pop
缺点:占用内存多
使用区别:
(1)如果你需要高效的随即存取,而不在乎插入和删除的效率,使用vector
(2)如果你需要大量的插入和删除,而不关心随机存取,则应使用list
(3)如果你需要随机存取,而且关心两端数据的插入和删除,则应使用deque
3**、**list
非连续存储结构,具有双链表结构,每个元素维护一对前向和后向指针,因此支持前向/后向遍历。 支持高效的随机插入/删除操作,但随机访问效率低下,且由于需要额外维护指针 ,开销也比较大。每一个结点都包括一个信息快Info、一个前驱指针Pre、一个后驱指针Post。可以不分配必须的内存大小方便的进行添加和删除操作。使用的是非连续的内存空间进行存储。
优点:(1) 不使用连续内存完成动态操作。
(2) 在内部方便的进行插入和删除操作
(3) 可在两端进行push、pop
缺点:(1) 不能进行内部的随机访问,即不支持[ ]操作符和vector.at()
(2) 相对于verctor占用内存多
使用区别:
(1)如果你需要高效的随即存取,而不在乎插入和删除的效率,使用vector
(2)如果你需要大量的插入和删除,而不关心随机存取,则应使用list
(3)如果你需要随机存取,而且关心两端数据的插入和删除,则应使用deque
4**、vector VS. list VS. deque:**
a、若需要随机访问操作,则选择vector;
b、若已经知道需要存储元素的数目,则选择vector;
c、若需要随机插入/删除(不仅仅在两端),则选择list
d、只有需要在首端进行插入/删除操作的时候,还要兼顾随机访问效率,才选择deque,否则都选择vector。
e、若既需要随机插入/删除,又需要随机访问,则需要在vector与list间做个折中-deque。
f、当要存储的是大型负责类对象时,list要优于vector;当然这时候也可以用vector来存储指向对象的指针,
同样会取得较高的效率,但是指针的维护非常容易出错,因此不推荐使用。
关联容器:
容器适配器:
栈 stack
队列 queue
优先级队列 priority_queue
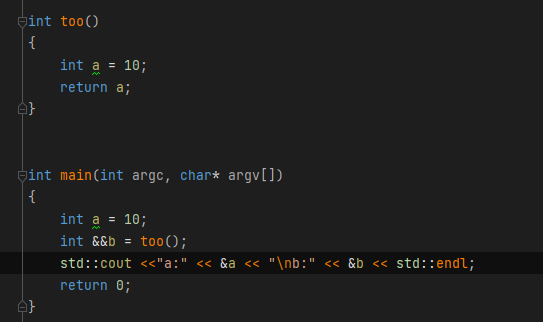
左值引用和右值引用
问:什么是左值引用,什么是右值引用
答:c++11之前,所有传统引用方式都是左值引用
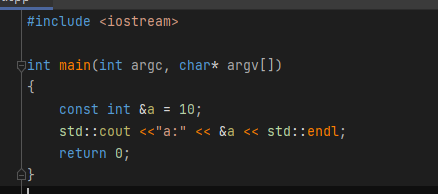
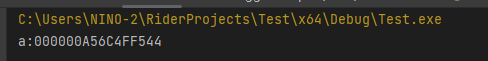
左值引用要求右边的值必须能够取地址,如果无法取地址,可以用常引用;
左值引用是对所有左值(可以取地址,有名字,非临时的)的引用,它是c++传统的引用方式
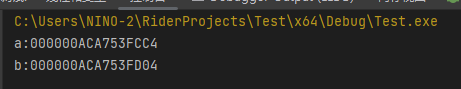
右值引用是对所有右值(不能取地址,没有名字,临时的值,如字面量)的引用,它是C++11的新特性,它与常量引用相似,都是创建一个新的地址来存放,但是区别是常引用只能读不能写,而右值引用可以读写
问:新建左值引用时会不会占据新的地址
答:不会,引用是别名,不会使用新地址
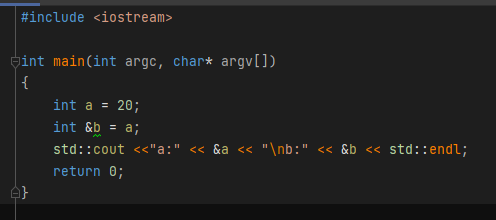
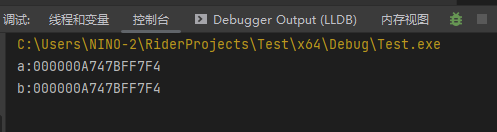
但是使用常引用引用字面量时会生成临时地址
问:为什么函数返回值是右值而不是左值
因为右值包括所有临时有效的值
函数返回值只在返回的时候有效,所以是右值引用